Comprendre le refus avant de modifier les protections
Vous ouvrez une page, enregistrez un contenu ou lancez une synchronisation, puis une réponse « 429 Too Many Requests » apparaît. Ce statut signale généralement qu’une limite de demandes sur une période a été atteinte. La règle peut appartenir à l’hébergement, à un service de protection ou à l’application appelée.
Le résultat recherché est de faire aboutir l’usage légitime avec une cadence compatible avec le service. Le numéro ne fournit pas une quantité universelle de requêtes autorisées pour WordPress. Il faut identifier qui compte les demandes, sur quel périmètre et pour quelle opération.
Un service externe peut aussi joindre un code détaillé qui précise ou nuance la signification de son 429. Conservez-le. N’augmentez pas la mémoire PHP et ne réinstallez pas WordPress pour corriger ce refus : ces interventions ne changent pas automatiquement une règle de fréquence.
Si seule une image ou une API distante échoue dans une page qui reste visible, relevez cette ressource. Son domaine peut désigner un autre responsable que votre hébergeur.
Préserver l’action et arrêter les répétitions
Copiez le texte non enregistré dans un document privé avant de fermer l’éditeur ou de vous déconnecter. Notez l’heure avec le fuseau, le chemin, l’action attendue et le message complet. Conservez une éventuelle référence de traitement, sans jeton ni donnée sensible.
Arrêtez les clics répétés et les outils qui recommencent immédiatement la même demande. Plusieurs onglets, un rafraîchissement automatique ou une synchronisation lancée plusieurs fois peuvent entretenir le problème. Coordonnez les essais de l’équipe afin qu’une personne observe pendant que les autres interrompent leurs relances manuelles.
Une demande d’écriture précédente peut avoir eu un effet même si vous voyez ensuite un refus. Contrôlez l’état du brouillon, de la commande ou de l’envoi avant de recommencer. Le diagnostic d’un 429 ne demande pas de créer un paiement réel supplémentaire.
Si une tâche automatique paraît impliquée, faites identifier sa fonction avant de la suspendre. Couper globalement toutes les tâches ou supprimer leur file pourrait empêcher des sauvegardes et opérations utiles sans corriger la demande qui se répète.
Respecter le délai de reprise indiqué
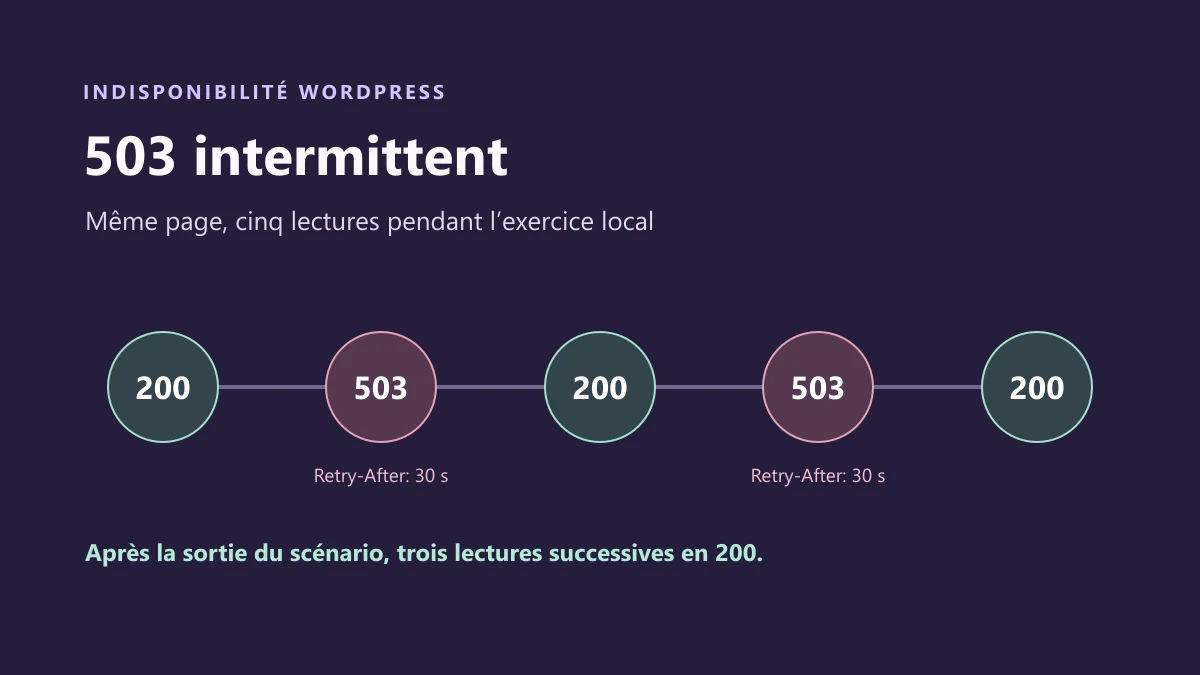
La réponse peut contenir Retry-After, une indication HTTP précisant quand refaire une demande. Sa valeur peut être une durée en secondes ou une date. L’absence de cet en-tête ne signifie pas que les demandes répétées sont permises ; cherchez alors la durée documentée par le service ou donnée par son support.
Consultez les indications déjà reçues avant un nouvel essai. Si l’outil possède une stratégie de reprise documentée, laissez-la agir plutôt que lancer parallèlement une reprise manuelle. Deux mécanismes de répétition peuvent additionner leurs demandes.
Attendez la période indiquée, puis faites une lecture ordinaire unique lorsque c’est approprié. Si le refus persiste, notez cette observation et passez au diagnostic de sa provenance. Vous n’avez pas à deviner une fréquence en testant successivement des rafales plus petites.
Pour un outil automatisé, le mainteneur doit prévoir une reprise espacée et limitée, adaptée à l’opération. Elle ne doit pas transformer une opération sensible en répétition aveugle ni continuer indéfiniment lorsque le service refuse toujours.
Localiser la demande réellement refusée
Dans les outils du navigateur, ouvrez Réseau et sélectionnez la demande liée à l’action. Relevez son domaine, son chemin, sa méthode et son statut, puis le message de réponse. Évitez de confondre la page principale avec une ressource distante ou une demande d’arrière-plan.
Un 429 visible dans une fenêtre d’extension peut provenir d’une API externe, c’est-à-dire un service avec lequel l’outil échange des données. À l’inverse, un refus sur votre domaine peut être produit avant que WordPress ne commence son traitement. Le lieu d’affichage du message ne désigne donc pas automatiquement son émetteur.
Conservez un identifiant de requête lorsqu’il est fourni. L’hébergeur ou le responsable du service peut le rapprocher de ses journaux. Une capture nettoyée et quelques champs utiles suffisent souvent ; ne publiez pas d’export contenant cookies, clés d’API ou contenu privé.
Notez aussi si une seule fonction échoue ou si toutes les lectures sont refusées. Cette portée aide à choisir entre un client trop actif, une règle commune et une limite propre au service appelé.
Identifier les droits et le parcours de correction
La consultation du navigateur est accessible au lecteur, mais les réglages d’un pare-feu ou d’un quota demandent les droits du responsable concerné. Votre rôle d’administrateur WordPress ne vous autorise pas automatiquement à modifier le service de protection ni le compte d’une API.
Relevez l’hébergement, les services intermédiaires et les versions des composants liés à l’action. Sans ces informations, demandez une vérification au mainteneur plutôt que d’installer un nouvel outil. Le propriétaire du site peut faire intervenir son prestataire sans partager ses identifiants.
Le premier parcours réduit une sollicitation identifiée dans le navigateur ou un outil. Le deuxième fait vérifier le compteur qui attribue les demandes à cet usage. Le troisième examine une intégration ou une tâche qui atteint une limite distante.
Si le service appliquant la limite reste inconnu, commencez par le dossier horodaté et les journaux. Les trois parcours ne sont pas trois changements obligatoires : l’observation doit désigner lequel possède les moyens de corriger le problème.
Approche 1 : réduire les demandes inutiles
Après avoir préservé le travail, gardez un seul onglet utile et arrêtez les rechargements automatiques que vous contrôlez. Si un outil lance des vérifications répétées, notez sa fréquence avant de le mettre en pause. Attendez le délai annoncé puis reprenez une lecture ordinaire.
Si le problème semble propre à votre navigateur, comparez ensuite avec un profil sans extension supplémentaire. Cette comparaison sert à isoler une extension qui rafraîchit ou automatise les demandes ; elle ne doit pas devenir une manière de multiplier les essais pendant le blocage. Ne nettoyez pas les données locales avant d’avoir copié le travail.
Lorsqu’un outil possède un réglage documenté de fréquence ou de concurrence, le responsable peut réduire uniquement cette valeur. Conservez l’ancienne configuration et vérifiez que sa fonction reste utile. Un outil de surveillance peut devenir trop peu réactif si son intervalle est allongé sans tenir compte du besoin.
Si le 429 revient avec une activité ordinaire et sans répétition identifiée, ne continuez pas à fermer des onglets au hasard. Faites vérifier le compteur et la règle qui ont effectivement déclenché le refus.
Approche 2 : retrouver la règle qui a compté les demandes
Le responsable de la protection recherche l’événement à l’heure du refus, avec le domaine, le chemin et l’identifiant disponibles. Un pare-feu applicatif examine les demandes avant leur traitement ; il peut appliquer une règle de fréquence distincte des permissions de votre compte WordPress.
Avec Cloudflare, le tableau Security Events permet cette recherche. Dans la navigation actuelle, ouvrez Analytics puis Events pour la zone concernée. Filtrez la période et le trajet utiles, puis consultez l’action et le service appliqués. Les journaux affichés peuvent être échantillonnés ; l’absence d’une ligne ne suffit pas à exclure le service.
Demandez quel critère regroupe les demandes : adresse, compte ou autre caractéristique, selon l’outil. Un clic peut déclencher plusieurs échanges ; le compteur ne correspond pas nécessairement au nombre de clics visibles. Des sous-requêtes techniques peuvent aussi intervenir dans certaines configurations.
Le résultat attendu est une règle et un événement concordants. Si ce lien manque, poursuivez l’analyse avec l’hébergeur ou l’éditeur pour confirmer l’attribution.
Faire confirmer le périmètre d’un compteur inattendu
Le responsable identifie la règle actuelle, sa période de comptage, son périmètre et la durée de la restriction. Ces valeurs peuvent être différentes. Un compteur commun peut regrouper des opérations qui appartiennent à des outils ou à des sites distincts. Si le journal indique une attribution incorrecte, transmettez le cas au propriétaire de la configuration pour qu’il vérifie le critère sur une copie et conserve l’état initial.
Pendant cette analyse, respectez le délai indiqué et réduisez le nombre de demandes évitables. La modification d’un client doit être justifiée par son usage. Par exemple, si deux tâches font le même contrôle au même moment, gardez une seule tâche ou espacez-les selon les besoins. Un dépassement de la limite officielle d’un service externe se traite en adaptant l’usage et en consultant le fournisseur sur les options qu’il documente.
Vérifiez ensuite un cycle ordinaire et un témoin, sans provoquer un nouveau 429. Si l’attribution a été modifiée et que le résultat devient incohérent sur un autre parcours, demandez au responsable de revenir au réglage précédent. Gardez la limite en place pendant l’examen.
Examiner une adresse partagée ou un mauvais regroupement
Plusieurs utilisateurs d’un même réseau peuvent être vus sous une seule adresse publique. Si la règle compte par adresse, leurs demandes peuvent se retrouver dans le même ensemble. Faites vérifier cette possibilité lorsque plusieurs personnes légitimes sont touchées, sans conclure automatiquement à un abus d’un seul compte.
Un proxy ajoute une autre question : quelle adresse le serveur utilise-t-il réellement pour identifier le client ? Une configuration incorrecte peut regrouper des visiteurs sous l’adresse du relais. Le technicien compare les journaux et la chaîne de proxys attendue, sans rendre l’origine publique.
La correction de l’adresse client doit préserver les sources de confiance. Il ne faut pas accepter comme authentique n’importe quelle adresse annoncée dans un en-tête par un visiteur. Ce réglage appartient à l’administrateur du serveur et du proxy, avec conservation de la configuration précédente.
Une limite peut aussi s’appliquer à tout un compte ou à une route commune. Faites nommer la clé de comptage avant de changer une attribution utilisateur ou de demander un quota individuel qui ne correspond pas à la règle réelle.
Approche 3 : vérifier les limites d’un service externe
Si le refus vient d’une API distante, consultez le journal de l’intégration et sa documentation officielle. Relevez le code détaillé, l’identifiant de requête et le contexte du compte concerné, sans copier sa clé. Le support de ce service peut confirmer la limite réellement appliquée.
Une limite de fréquence et une limite de demandes simultanées sont distinctes. Diminuer le nombre d’opérations en parallèle peut aider dans le second cas, tandis qu’un quota global demande de coordonner tous les outils qui utilisent le même compte. Modifier le pare-feu de WordPress ne change pas cette capacité distante.
Stripe constitue un exemple de cette nuance : ses réponses peuvent préciser le type de limitation, et certains 429 concernent un verrou d’objet plutôt qu’un quota de fréquence. Si vous utilisez cette intégration, faites interpréter son code par son mainteneur ; ne généralisez pas cette signification aux autres services.
La correction peut consister à réduire les appels inutiles ou à adapter la cadence documentée. Une augmentation de quota éventuelle doit être confirmée par le fournisseur, sans promesse qu’un changement d’offre résoudra une répétition défectueuse.
Maîtriser les reprises et les tâches de fond
Le mainteneur de l’intégration doit examiner les demandes qui se répètent après chaque refus. Un mécanisme de reprise bien conçu espace les tentatives et respecte les indications du service. Il tient aussi compte du nombre total de tentatives et des effets possibles de l’opération.
Certaines documentations d’API prévoient une attente progressivement augmentée avec une part d’aléa, afin que plusieurs clients ne recommencent pas tous ensemble. Utilisez la stratégie prévue par l’outil et son fournisseur ; ne fabriquez pas un nouveau script de relance pour terminer l’import.
Si Action Scheduler est déjà présent, consultez les journaux des actions concernées dans Outils, Actions planifiées, ou dans WooCommerce, État, Actions planifiées selon l’installation. Cette bibliothèque peut être intégrée à un composant ; il n’est pas nécessaire d’installer une nouvelle extension pour cette seule recherche.
Ne videz pas les actions échouées et ne cliquez pas sur Exécuter pour les reprendre toutes. Identifiez celles qui ont déjà produit un effet et celles qui doivent attendre le rétablissement du service. Le guide des tâches de fond détaille ce suivi.
Tenir compte de WordPress.com et des réglages partagés
Sur WordPress.com, utilisez le support et les outils accessibles pour le site concerné. Le service peut appliquer ses propres limitations, et un composant peut également produire des appels excessifs. Ne transposez pas une modification de serveur Nginx ou de pare-feu externe à une configuration que vous ne gérez pas.
Sur une offre autohébergée administrée, l’hébergeur peut être le seul à modifier la règle. Donnez-lui le chemin et le scénario légitime à préserver. Une demande précise permet de vérifier le périmètre du comptage et la cadence attendue.
En multisite, associez le responsable du réseau avant de modifier un composant actif sur plusieurs sites. Une intégration ou un quota commun peut additionner leurs demandes. Indiquez les sites touchés, les comptes de service partagés et les périodes de lancement, sans divulguer leurs secrets.
Après correction d’une cadence commune, vérifiez les fonctions des autres sites concernés. Une synchronisation ralentie pour résoudre un refus peut avoir retardé une mise à jour nécessaire ailleurs dans le réseau.
Vérifier une reprise normale sans chercher le seuil
Après la correction et le délai nécessaire, reprenez une lecture ordinaire puis le parcours légitime qui échouait. Vérifiez le statut et le contenu reçus. Pour un enregistrement, utilisez un brouillon de contrôle puis rouvrez-le. Ne déclenchez pas un paiement ou un envoi réel seulement pour constater que le refus a disparu.
Observez aussi la cadence de l’outil concerné sur son cycle normal. Le support doit pouvoir confirmer l’absence de nouveaux refus sur ce même trajet, sans qu’un autre client consomme silencieusement tout le quota. Un seul succès après une pause n’explique pas encore la récidive.
Si plusieurs utilisateurs ou sites partageaient le compteur, vérifiez leur usage habituel de manière coordonnée. Vous ne cherchez pas le nombre exact de clics qui provoque un blocage ; vous vérifiez que la règle et le client permettent le travail prévu.
Si le 429 revient, conservez l’heure et le code détaillé, puis faites réexaminer la correction. Comparez le nouvel événement au relevé précédent et vérifiez la cadence effective avant d’ajuster un autre réglage.
Revenir à une cadence validée après l’essai
Conservez la fréquence et le nombre de tâches actives avant l’intervention. Si le client devient trop lent ou omet des données, comparez ce résultat au besoin réel et recherchez un autre réglage qui respecte les conditions du service. Par exemple, faites réutiliser une donnée déjà lue au lieu de répéter la même demande. Vérifiez aussi les autres outils qui utilisent le même compte. Le résultat doit rester utile pendant un cycle normal de travail.
Ne remettez une ancienne fréquence que si elle est compatible avec la capacité confirmée et si le défaut qui faisait répéter les demandes est résolu. Reprenez progressivement les tâches nécessaires et vérifiez ce qu’elles ont déjà traité pour éviter de dupliquer une opération. Si un nouveau refus apparaît, arrêtez les relances manuelles et conservez l’identifiant et le délai du dernier événement.
Une réponse 429 ne doit pas être stockée par un cache conforme. Si un ancien refus paraît persister après résolution, faites vérifier la copie identifiée en cache et sa politique de conservation. Le contrôle doit également confirmer que les demandes n’arrivent plus au rythme qui déclenchait le refus.
Constituer le dossier et prévenir un nouveau dépassement
Le dossier utile contient le service visé, le chemin, l’heure avec fuseau, la méthode, le code 429, le code détaillé éventuel et le délai proposé. Ajoutez l’identifiant de requête, le composant demandeur, sa version et sa fréquence connue. Indiquez ce qui fonctionne encore et les essais déjà réalisés.
Demandez au bon responsable de confirmer le périmètre du compteur et la correction retenue. Si la cause reste inconnue, gardez cette limite dans le compte rendu et convenez des journaux à préserver à la prochaine occurrence. Un refus qui disparaît après attente peut revenir si les mêmes demandes continuent.
Pour la suite, coordonnez les outils utilisant le même compte, espacez les travaux non urgents et gardez les stratégies de reprise documentées. Avant une opération volumineuse, vérifiez les contraintes du service et la méthode de continuation prévue, sans multiplier les tentatives manuelles.
Le bon résultat est un usage légitime qui aboutit durablement avec les protections nécessaires. Conservez la configuration validée et le contact du responsable du compteur pour pouvoir corriger une évolution de cadence sans reprendre toutes les hypothèses.
Distinguer un pic normal, une boucle et la limite d’un service
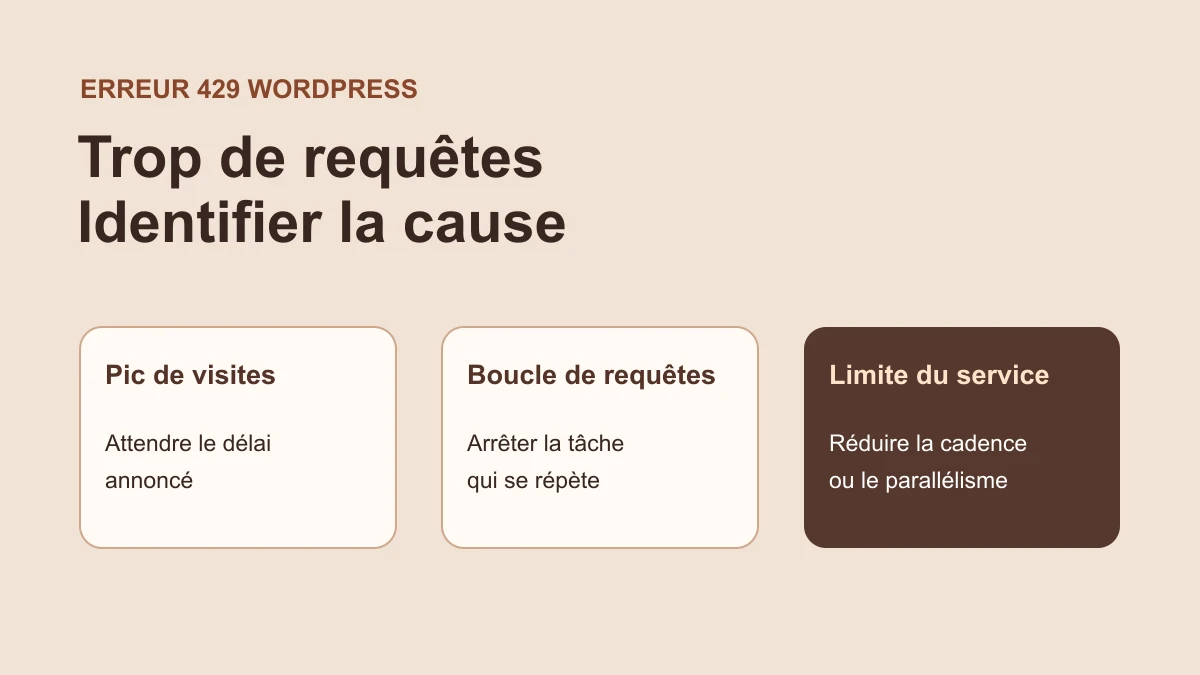
Comparez une période qui contient le refus et une période habituelle. Un pic normal peut regrouper des visites distinctes juste après une annonce et retomber ensuite. Si le même chemin est demandé à intervalles réguliers par un seul outil, recherchez un rafraîchissement, une tâche dupliquée ou une reprise qui repart à chaque erreur. Si les pages du site restent disponibles et que seul un appel vers un autre domaine reçoit 429, cherchez les indications du service appelé. Le code seul ne distingue pas ces cas.
Dans les réponses fictives, le pic et la boucle sont signalés par la même couche de protection. Le journal du pic décrit plusieurs visites liées à une annonce. Celui de la boucle signale une même lecture périodique par une tâche. L’API fictive signale quant à elle une limite de demandes simultanées. Dans ce dernier cas, diminuer le parallélisme et consulter les règles du service répondent à un autre besoin que celui d’espacer des rafraîchissements du navigateur. Vérifiez le journal ou la documentation avant de modifier la cadence.
Lire un délai relatif, une date ou une indication absente
Un Retry-After de 120 demande d’attendre au moins 120 secondes avant la prochaine tentative éventuelle. Une valeur comme Wed, 11 Nov 2026 10:03:00 GMT désigne une heure absolue. Dans la recette, la réponse fictive est reçue à 10 h 00 UTC, soit trois minutes avant cette échéance. Faites tenir compte du fuseau et de l’horloge utilisée pour le calcul. Une date dépassée ou un délai terminé ne garantit pas que le compteur a de la place pour toutes les opérations en attente.
Une réponse sans cet en-tête ou avec une valeur illisible ne fournit pas de délai exploitable. Consultez alors la politique du service ou son support, puis gardez les reprises en attente selon ce cadre. L’essai lit une seule réponse par scénario et ne relance aucune requête. Il vérifie l’interprétation de la valeur, sans mesurer une limite ni sa fenêtre réelle.
Réduire la charge avant de reprendre un cycle
Pour un pic normal, décalez les tâches secondaires que vous contrôlez et évitez les relances manuelles pendant l’attente. Pour une boucle, faites arrêter la tâche précise, vérifiez les opérations déjà traitées et corrigez ce qui déclenche ses reprises. Pour une limite de service, utilisez la cadence et le nombre de demandes simultanées documentés. Les demandes identiques peuvent parfois partager un résultat déjà obtenu. Une tâche qui écrit exige une vérification de son état avant de la relancer.
Sur une copie ou avec des réponses fictives, comparez le nombre de demandes prévues pour un cycle avant et après correction. Le résultat attendu est une fonction qui reste utile avec moins d’appels et une reprise qui respecte l’attente. Gardez les anciennes valeurs pour comprendre l’effet de la modification. Si un nouveau 429 apparaît dans l’usage réel, consignez-le et reprenez le relevé plutôt que de chercher le seuil par essais successifs.